在人工智能技术飞速发展的今天,算力与算法已成为驱动创新的两大核心引擎。其中,以智能芯片构建的人工智能计算机集群为基础,并在此基础上进行人工智能基础软件的开发,构成了支撑大规模AI应用落地的关键基础设施。
一、智能芯片构建人工智能计算机集群
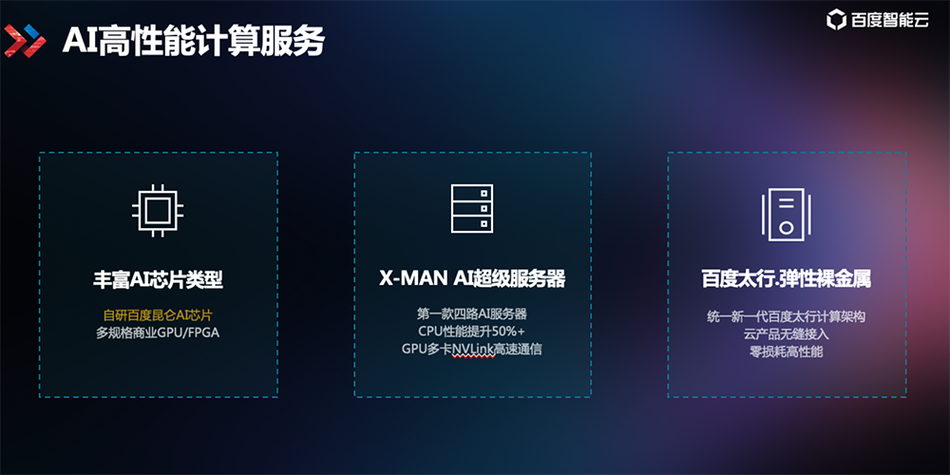
传统的通用CPU在应对深度学习海量矩阵运算时逐渐力不从心。为此,业界转向了专为AI计算设计的智能芯片,如GPU、TPU、NPU以及各类领域专用架构(DSA)芯片。这些芯片具备高并行度、低精度计算优化和高能效比的特点,能够大幅加速神经网络的训练与推理。
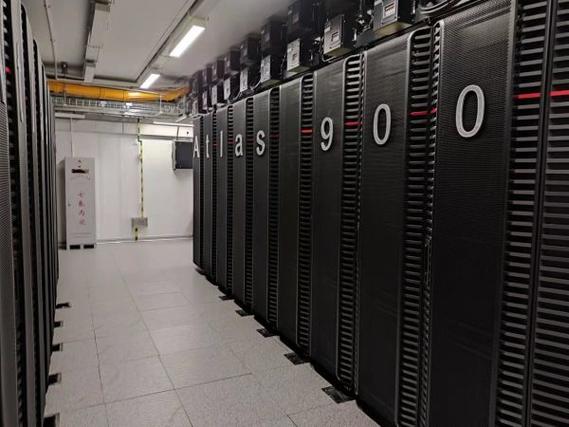
通过高速互联技术(如NVIDIA NVLink、InfiniBand或自研网络),成千上万颗智能芯片被组织成大规模计算机集群。集群中的每个节点通常包含多颗智能芯片,节点间通过高速网络实现参数同步与数据交换。这种集群架构不仅能提供艾级(ExaFLOPs)算力,还能通过分布式并行策略(数据并行、模型并行、流水线并行)支撑万亿参数级大模型的训练。
集群的构建还需要配套的高性能存储、冷却系统与电力管理。张量级存储与并行文件系统确保数据喂给芯片的速度不被瓶颈约束,液冷或风冷方案控制散热密度,而智能调度系统则按任务优先级和资源碎片情况动态分配算力。
二、基于智能芯片集群的人工智能基础软件开发
有了底层的芯片集群,还需要系统化的基础软件来“激活”算力潜能。人工智能基础软件通常分为以下几个层次:
- 芯片级驱动与运行时:与智能芯片架构紧密耦合,负责指令调度、内存管理、缓存优化与芯片间通信。例如CUDA(对应NVIDIA GPU)、ROCm(对应AMD)、CANN(对应华为昇腾)等,它们向高水平框架暴露统一或领域专用的接口。
- 分布式计算框架与通信库:解决多芯片、多节点下的并行效率问题。典型组件的代表包括NCCL(NVIDIA集合通信库)、Gloo、OpenMPI以及各类参数服务器。它们处理All-Reduce、Broadcast等通信原语,使大模型训练能在集群上高效扩展到数万张芯片。
- 深度学习框架:为用户提供构建模型的编程接口和自动微分机制,如PyTorch、TensorFlow、PaddlePaddle、MindSpore。框架需要针对智能芯片做深度适配,如图算子融合、混合精度训练、动态图/静态图转换,并利用集群特性实现容错与弹性训练。
- 模型压缩与推理引擎:针对实际部署场景,通过量化、剪枝、知识蒸馏降低模型体积和算力开销,同时配合推理后端(如TensorRT、OpenVINO、TNN)优化智能芯片上的执行效率,降低延迟与功耗。
- 开发工具链与平台:涵盖数据预处理、模型可视化、超参调优、自动化机器学习(AutoML)、实验管理与部署服务,帮助团队高效率地开发、迭代和上线AI应用。
三、协同优化的关键方向
硬件与基础软件需要无缝配合,才能实现最佳整体性能。主要的协同优化方向包括:
- 软硬件一体的算子编译器:利用TVM、MLIR等多层中间表达技术,使同一套算子能自动映射到不同智能芯片上,生成高效后端代码。
- 动态编译与运行时优化:根据输入形状、数据分布等功能做代码特化,提升缓存命中率,减少内存拷贝。
- 存算一体与近存计算支持:未来智能芯片可能引入存内计算单元,基础软件需调整数据流调度,发挥架构创新优势。
- 集群级弹性与容错:通过检查点,故障预测,任务重启和资源重调度,确保长时间训练在处理芯片失效时不中断任务。
- 绿色计算与能效管理:在调度算法和运行时层面不仅关注性能,也对集群功耗进行统一管控。
四、
以智能芯片构建的人工智能计算机集群提供物理世界的算力基座,而人工智能基础软件开发则决定了这片基座上能够生长出怎样的巨人模型和应用的大厦。从芯片架构到系统软件,从编程框架到工具链,每一层的演进都在推动AI技术更多地走向超级尺度并更具经济性。未来的核心突破,将越来越多地来自软硬件深度协同的系统级创新。